Consul Register Manager · 一站式 Prometheus Exporter 注册管理平台
前言:为什么做这个平台
在我们用 Prometheus + Consul 做服务发现的监控体系里,每接一台新机器、新数据库、新网站,标准的”人工 SOP”是这样的:
- SSH 到目标机器
- 部署对应的
node_exporter/mysqld_exporter/redis_exporter… - 手写 JSON 调 Consul API:
PUT /v1/agent/service/register - 填各种字段:
service_id、tags、meta、健康检查 URL - 错了再
deregister重新来
一个项目几十台机器,每个都要敲一遍 Consul API;批量?得写脚本;共享?得传 API Token;审计?谁改了什么?查不到。
一个晚上批量起 50 台新服,靠人一个个注册,是真的会出事的。
Consul Register Manager 就是为了把这套流程做成一个 Web 平台,让注册变成”贴文本框 + 点按钮”,并且所有写操作可追溯。
系统在监控体系中的位置
1 | ┌─────────────────────┐ |
Exporter 启动后自动暴露 /metrics,Consul 每 30 秒做一次健康检查(HTTP 探活),通过后被 Prometheus 拉取。Exporter 关闭后 24 小时连续失败会被 Consul 自动注销——僵尸注册也会自动消失。
核心能力
1. 批量注册 · 7 种 Exporter 模板
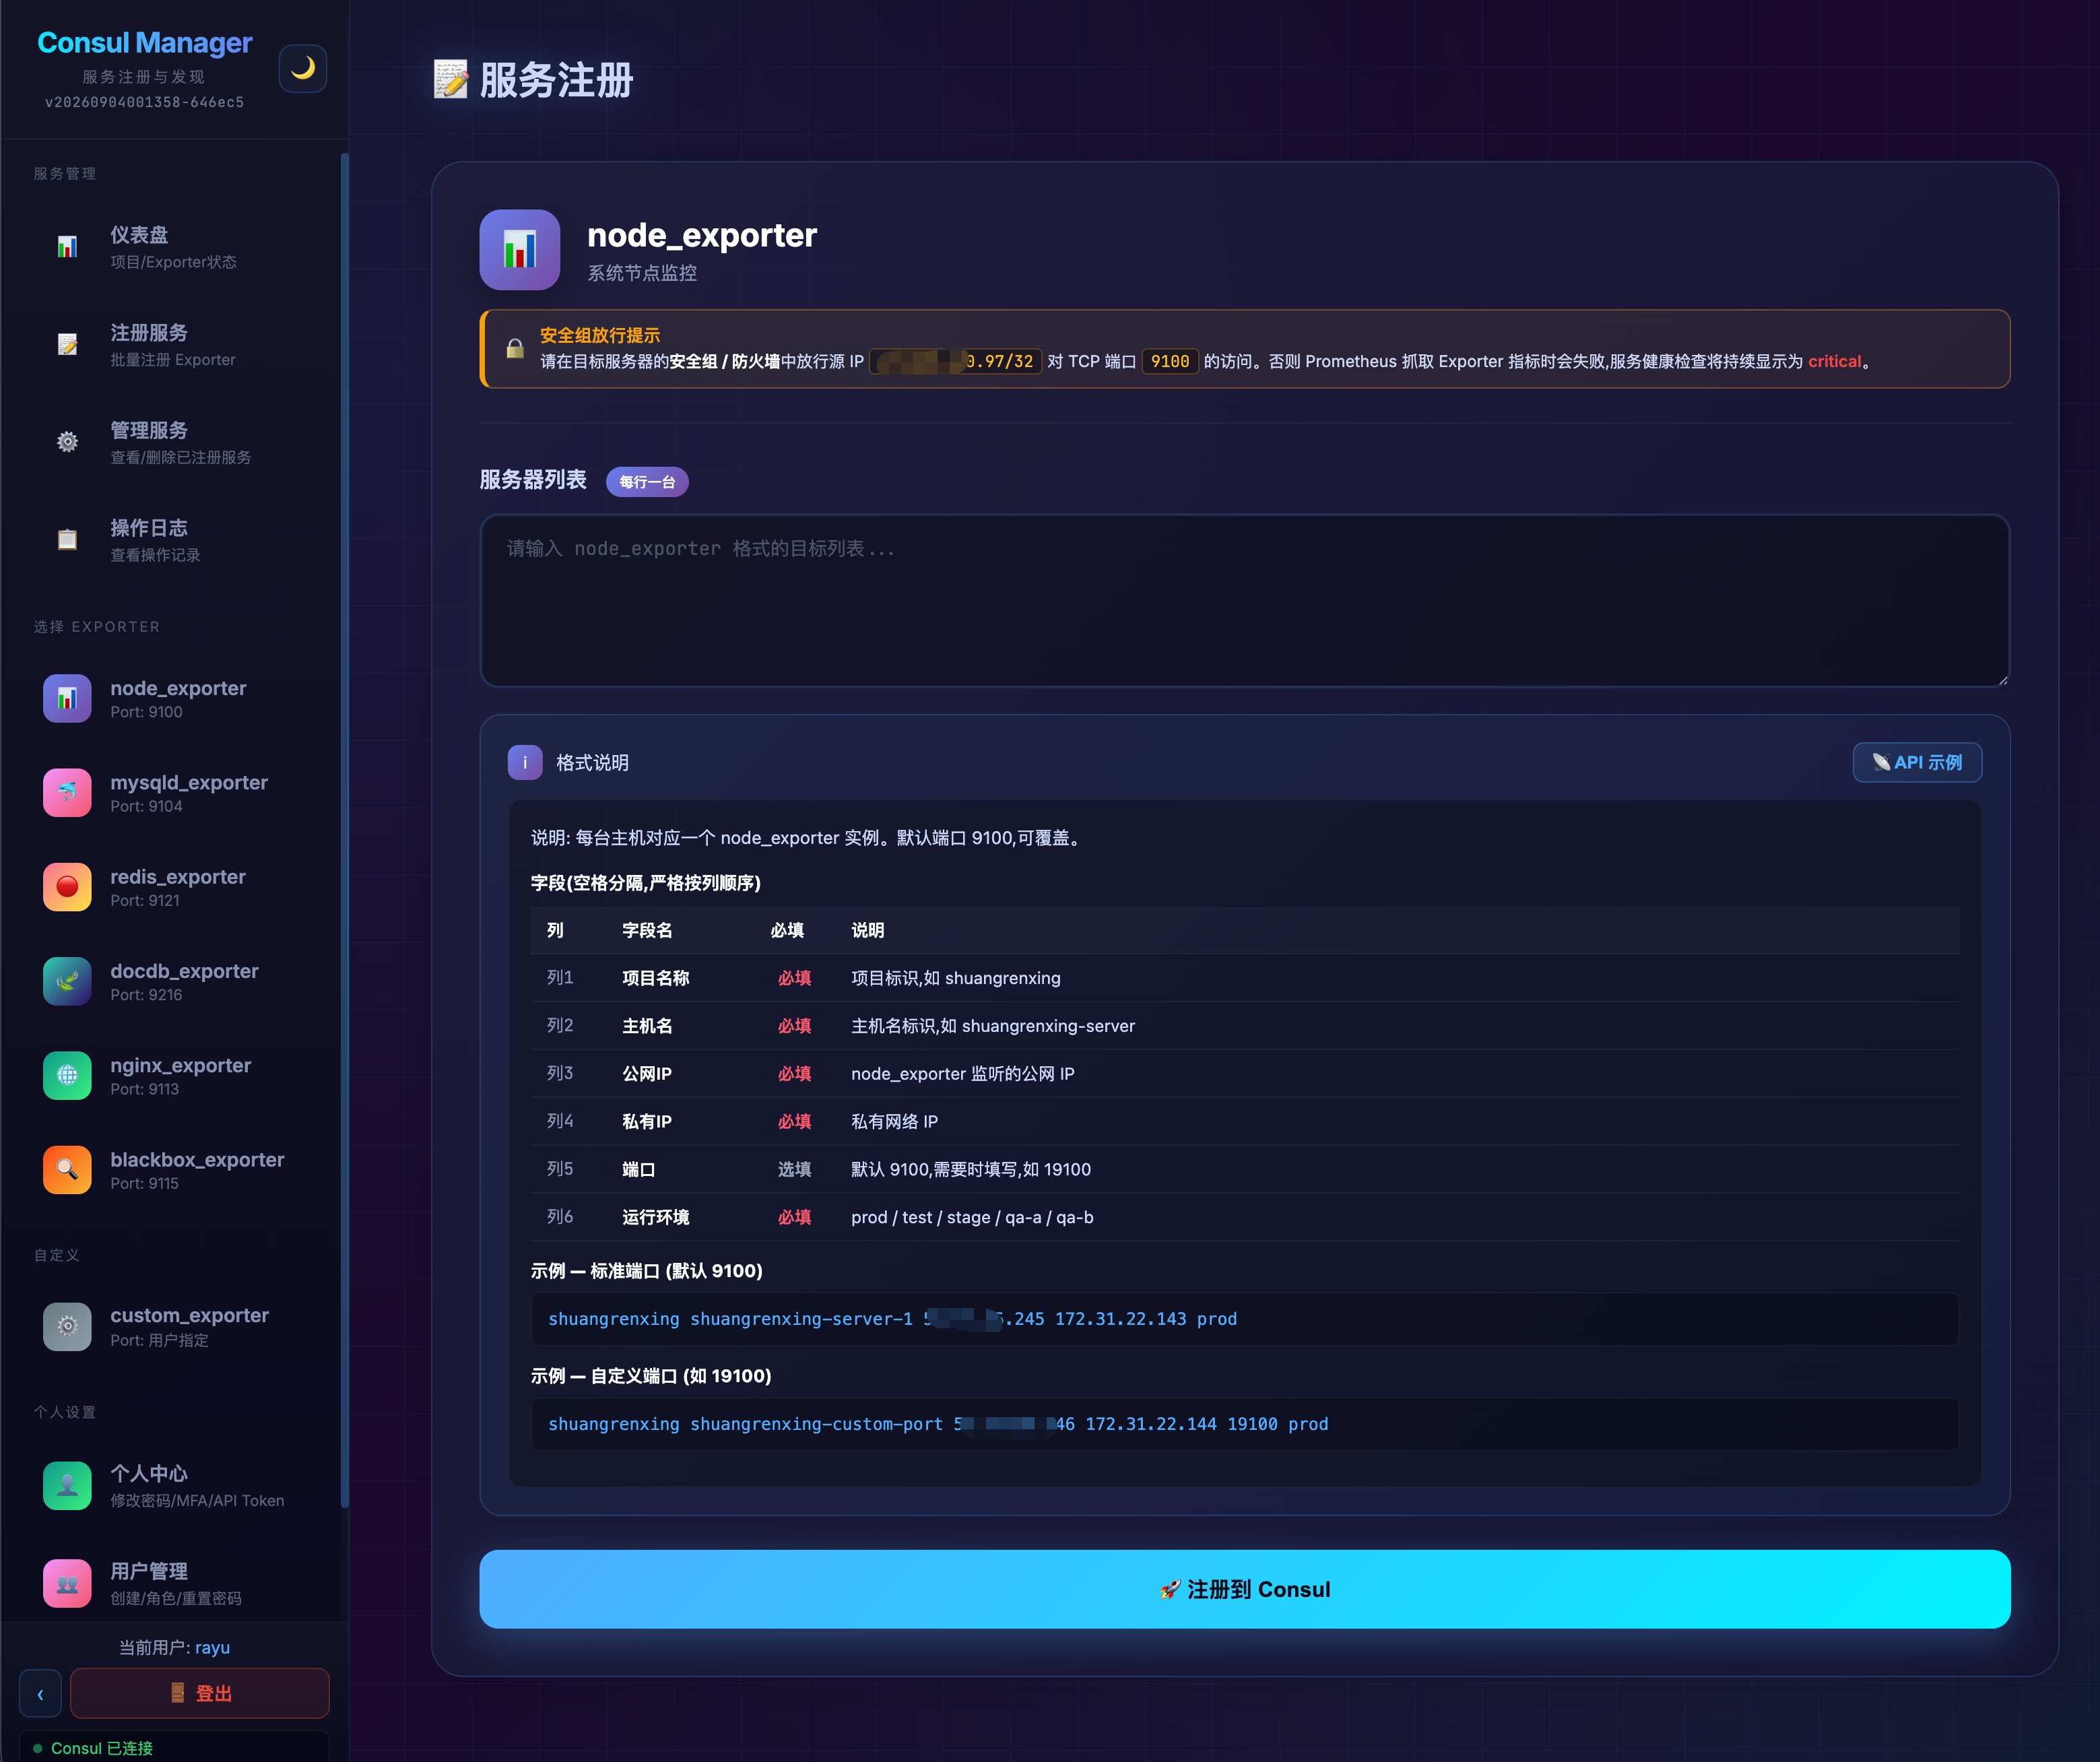
一行一台机器,按 Exporter 类型走不同格式:
| Exporter | 端口 | 适用场景 | 注册格式 |
|---|---|---|---|
node_exporter |
9100 | Linux 服务器硬件/OS 指标 | 项目 主机 公网IP 私网IP 环境 |
mysqld_exporter |
9104 | MySQL 数据库 | 项目 目标 库名 环境 |
redis_exporter |
9121 | Redis | 项目 目标 库名 环境 |
docdb_exporter |
9216 | 阿里云 MongoDB (DocumentDB) | 项目 目标 库名 环境 |
nginx_exporter |
9113 | Nginx | 项目 主机 公网IP 端口 环境 |
blackbox_exporter |
9115 | HTTP/TCP/ICMP 黑盒探测 | 项目 模块 目标 [探测IP] 备注 环境 |
custom_exporter |
自定义 | 自研 / 第三方 | 项目 IP 端口 环境 备注 采集路径 |
举个例子,要给 spg2 项目批量起 5 台 node_exporter,文本框里直接贴:
1 | spg2 spg2-1 1.1.1.1 10.0.0.1 prod |
点”注册到 Consul”——5 个 service_id 批量入 Consul,几分钟后 Prometheus 自动开始抓取。
2. 服务管理
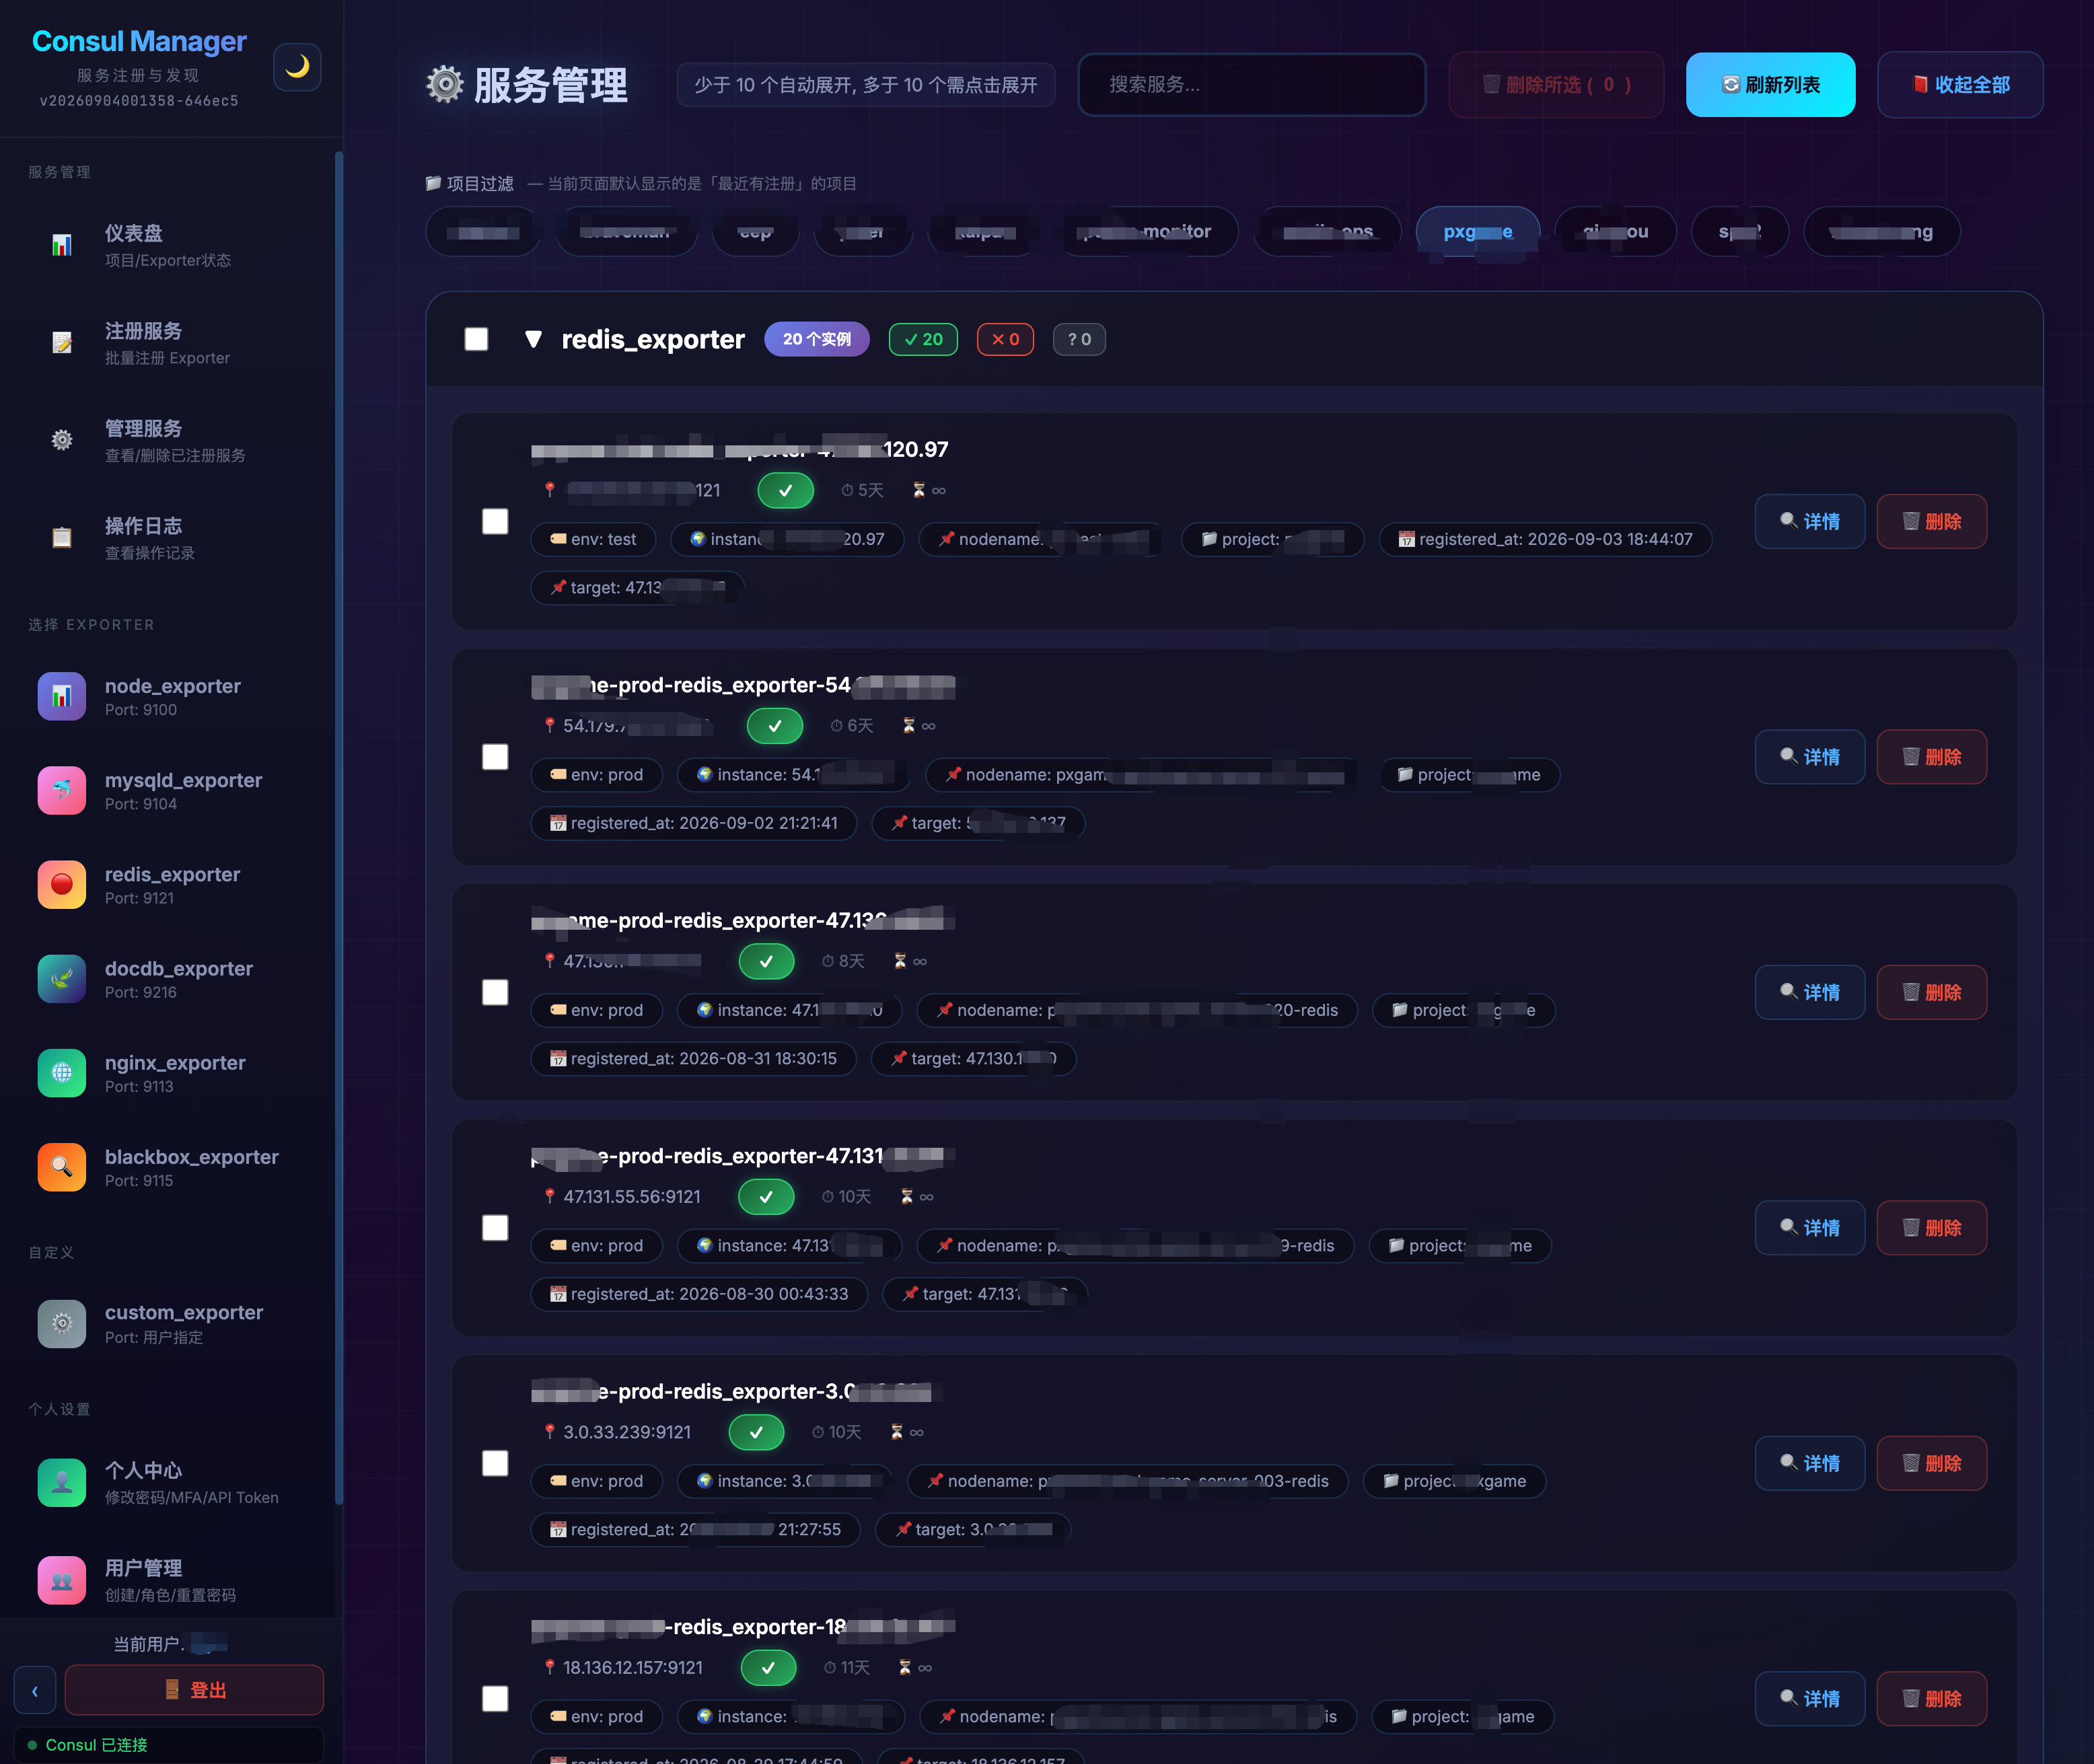
- 看 Consul 中已注册的所有服务
- 按 Exporter 类型 / 项目 / 关键字搜索
- 单独删除某个服务实例
- 一键删除某个类型的所有服务
服务详情
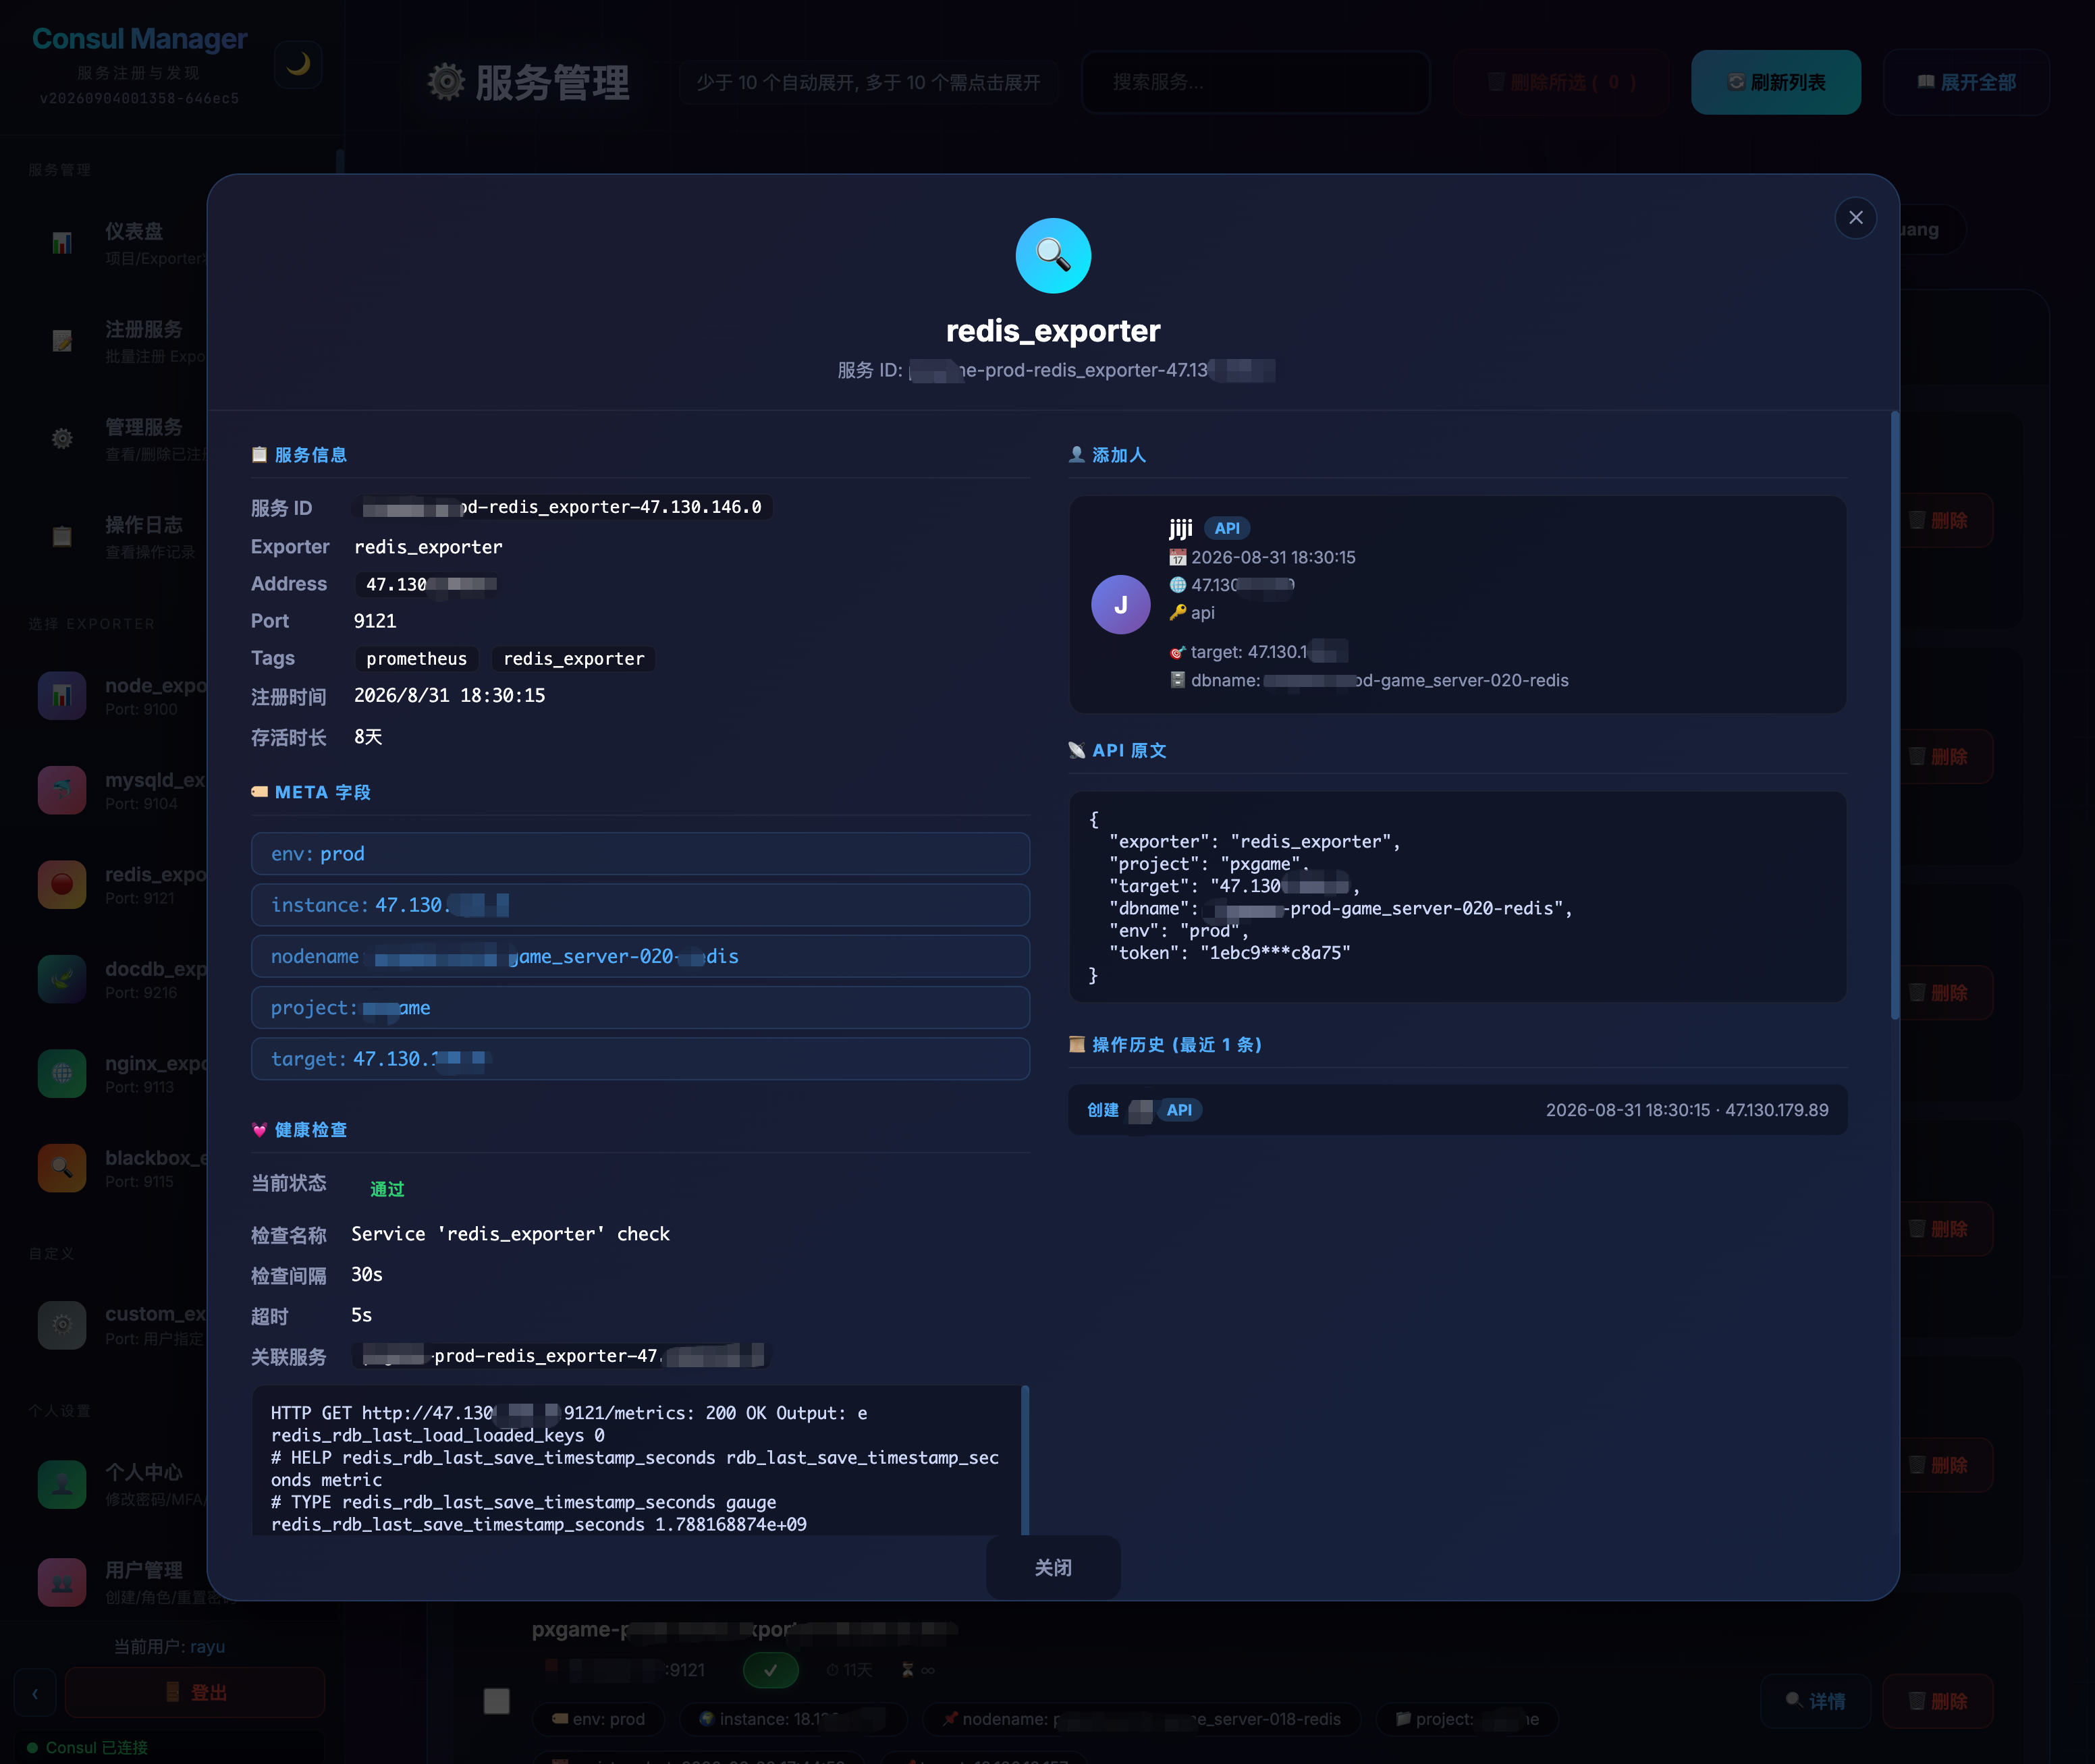
点击某个服务实例查看完整详情:
- 基础信息:Service ID / Address / Port / Tags
- 元数据 Meta:项目 / 团队 / 环境等自定义键值对
- 健康检查:检查类型(HTTP / TCP / Script)/ 间隔 / 超时 / 状态
- 所在节点:物理机 / K8s 节点 / 容器信息
3. 健康检查可视化
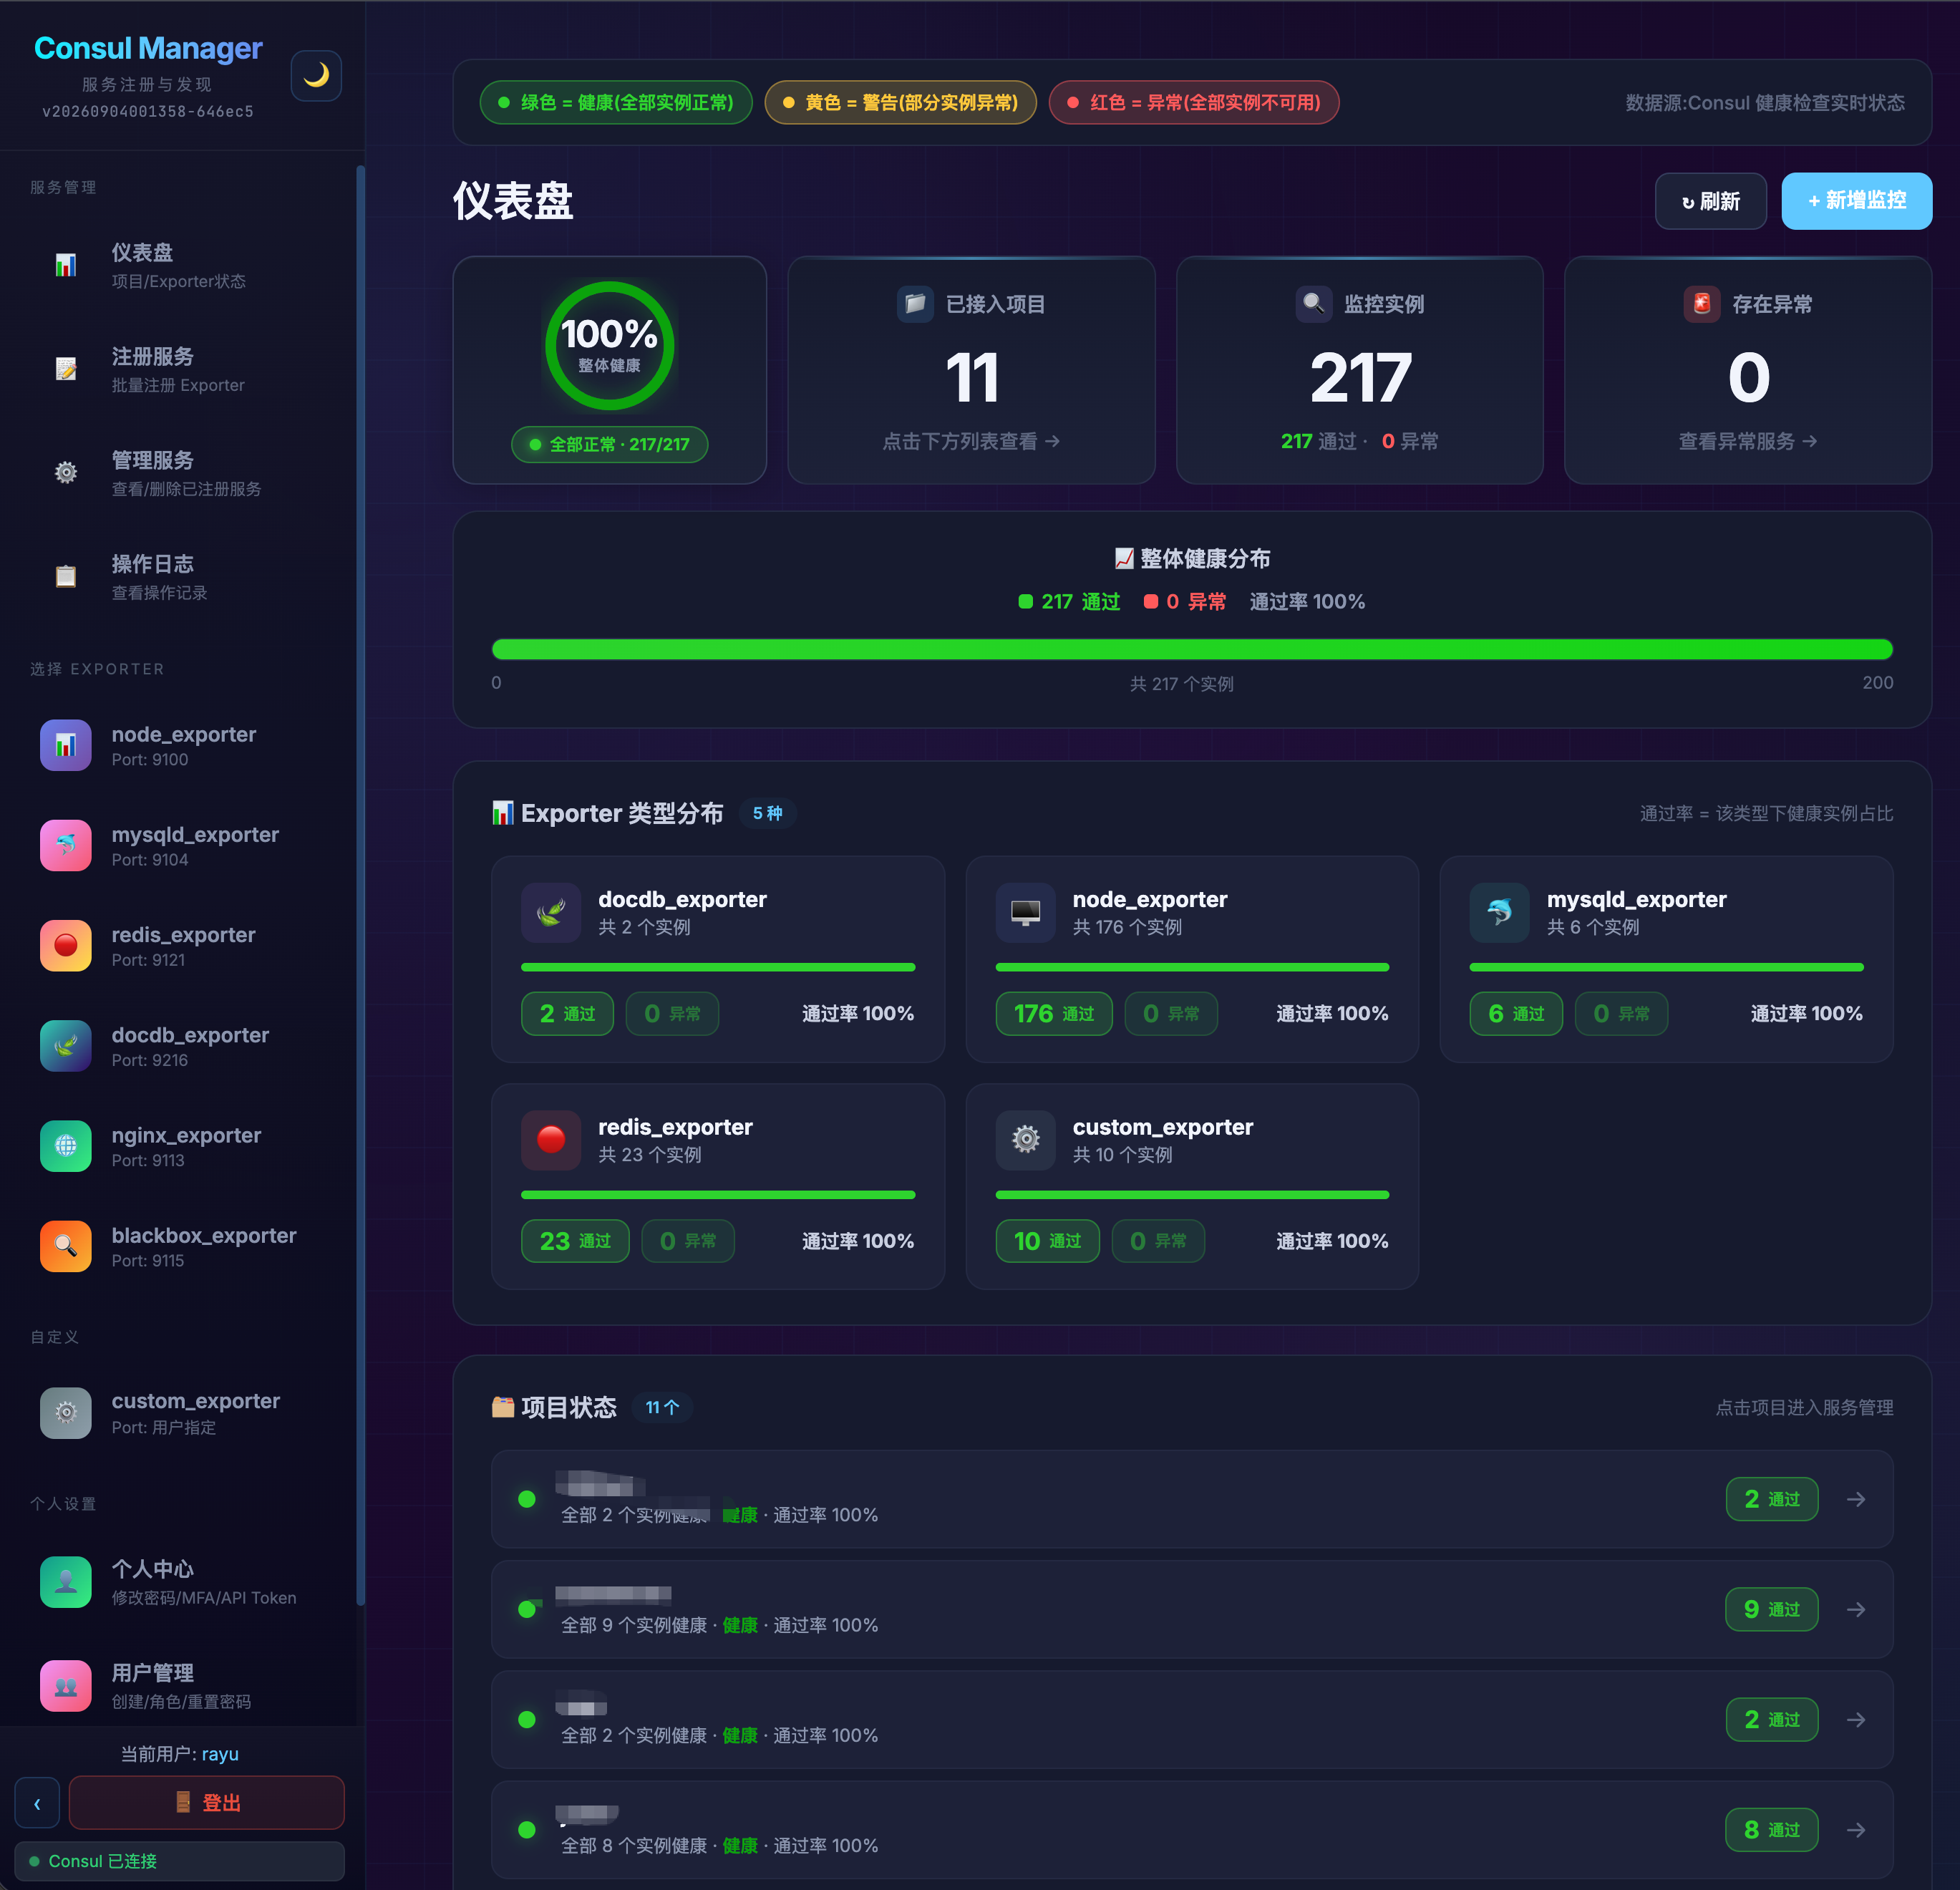
仪表盘展示:
- 已接入项目数
- Exporter 实例总数
- 各类 Exporter 的
passing/critical/unknown状态 - 服务注册时长(自动注销倒计时)
4. 操作日志 · 审计可追溯
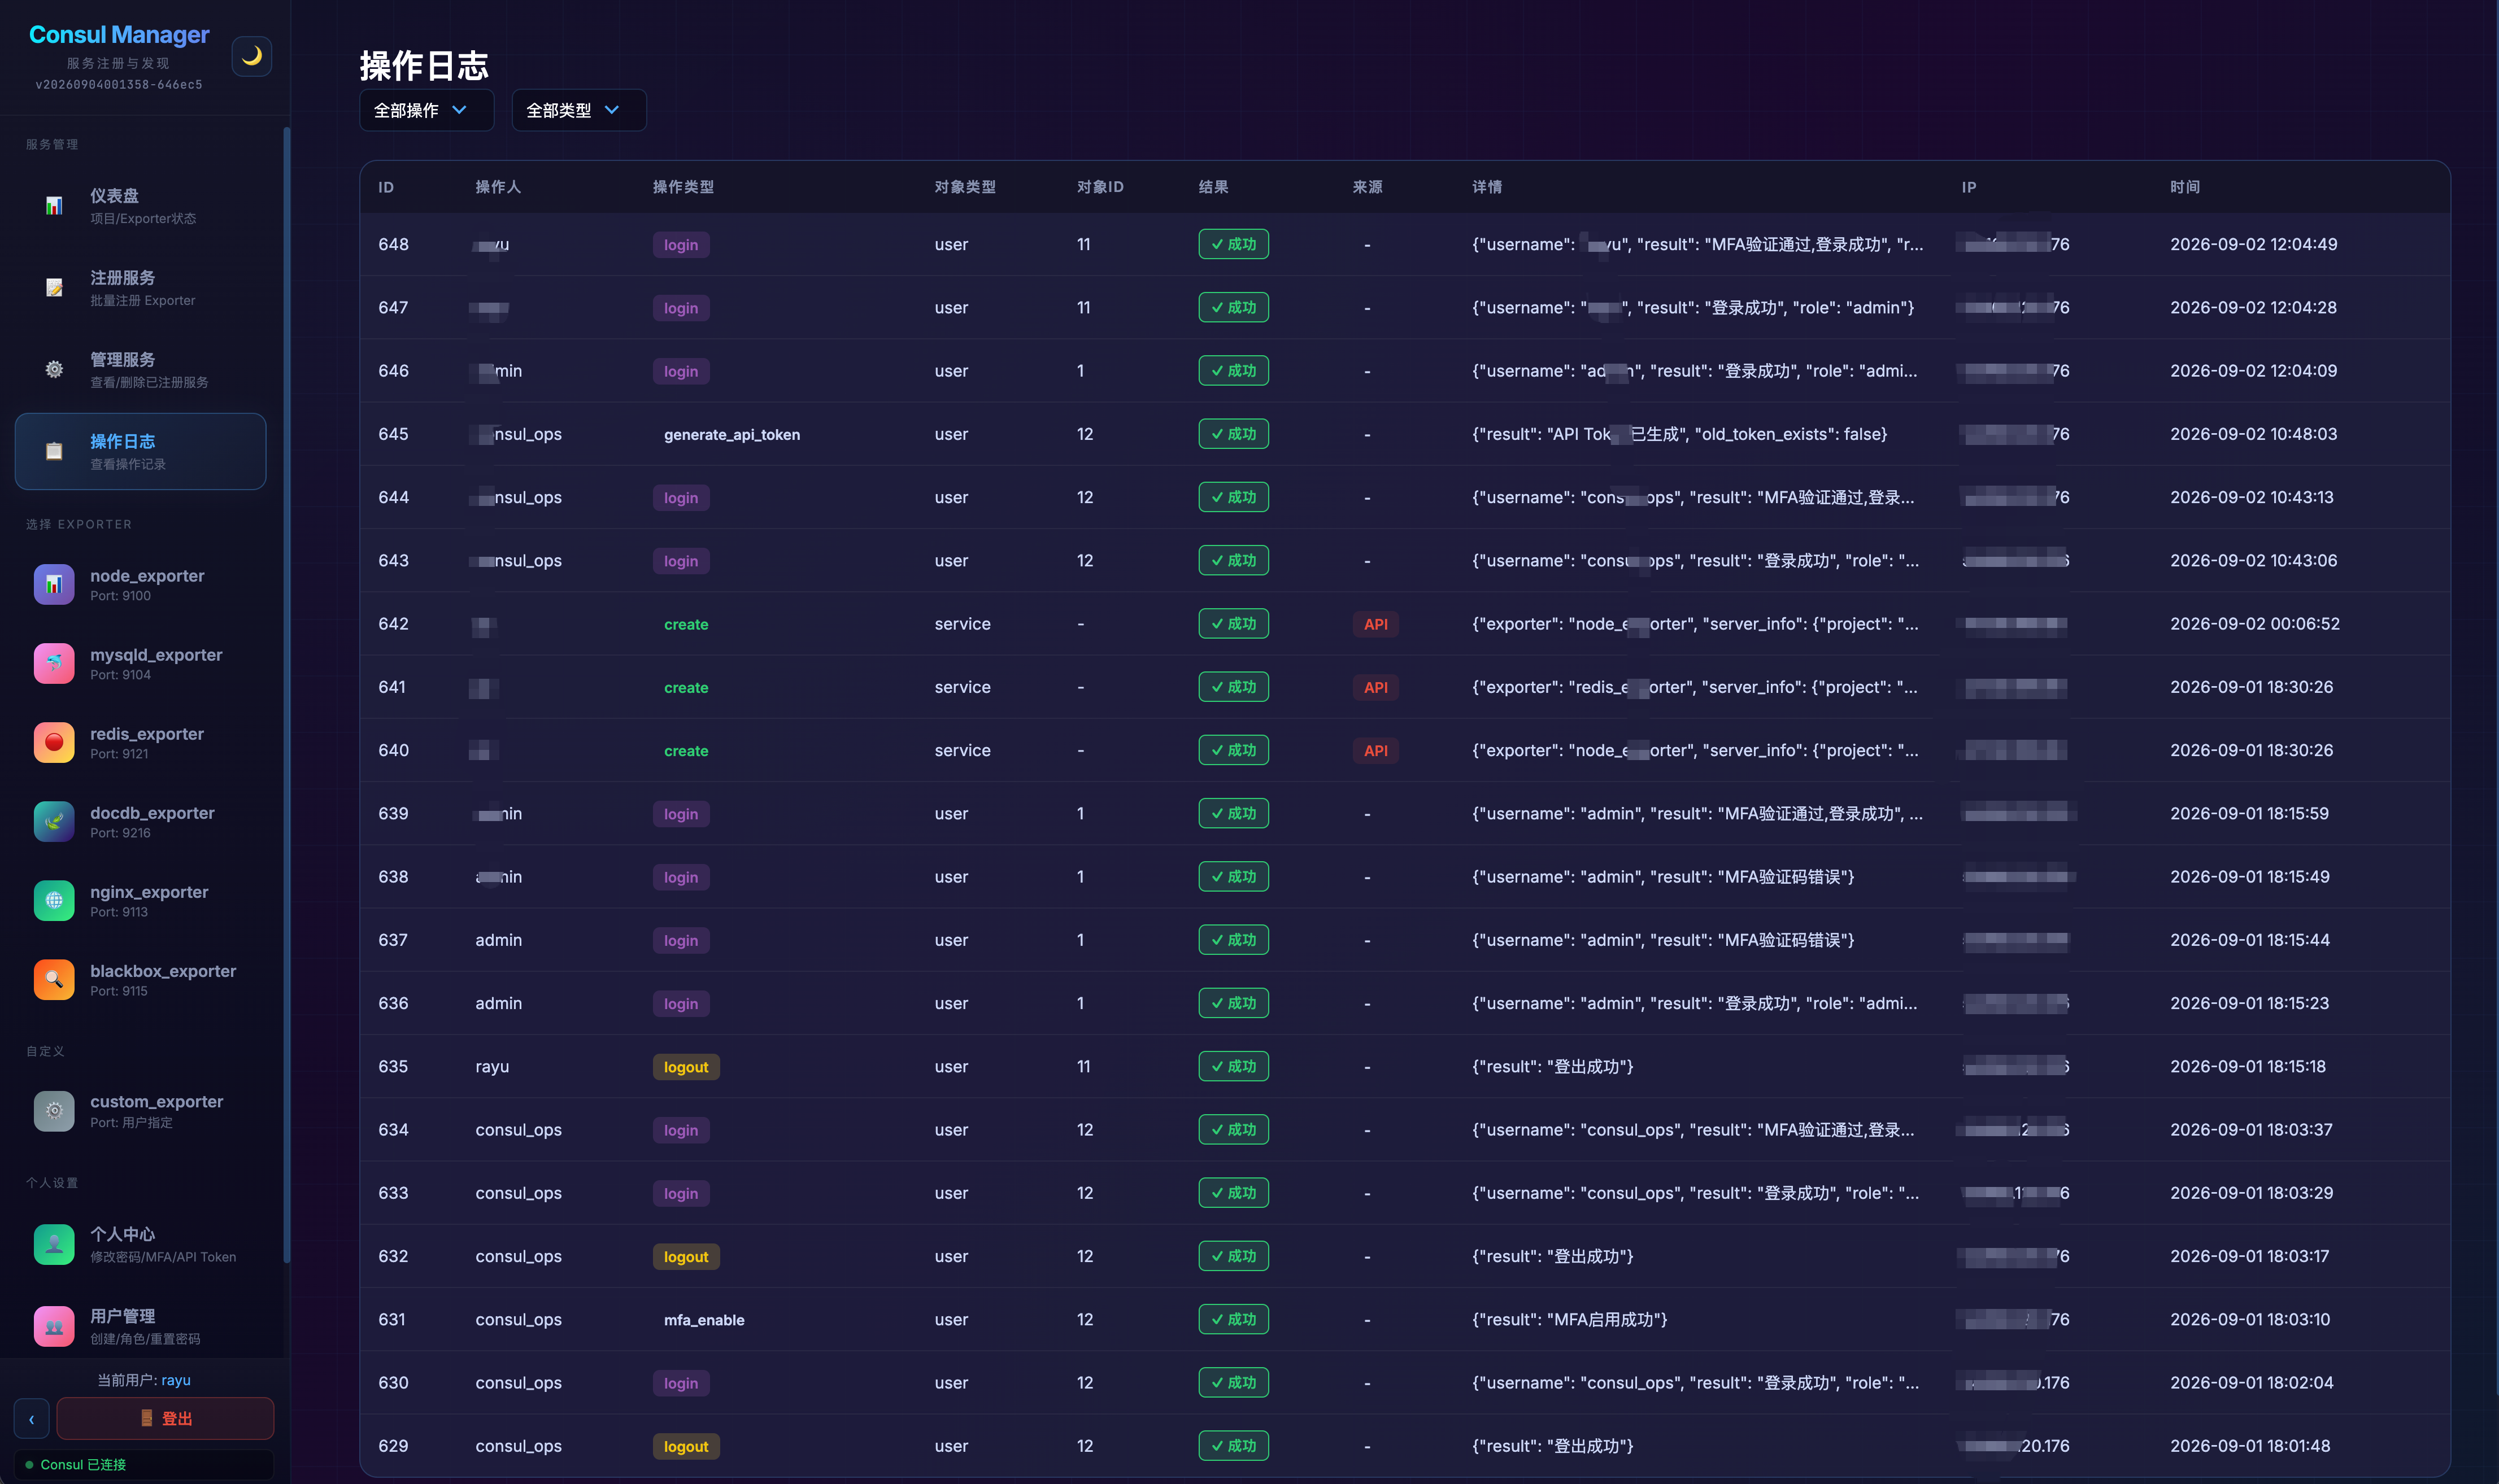
「操作日志」记录所有变更事件:
- 谁(操作人)
- 什么时候(精确到秒)
- 做了什么(create / update / delete / login / logout)
- 通过什么渠道(Web / API)
- 客户端 IP
可按操作类型、对象类型过滤。任何一次注册都能查到:谁注册的、什么时候、哪台机器、IP 是多少——满足内部审计、甲方合规、SOC2 等场景。
5. 安全 · MFA + Token + 只读账号
用户管理
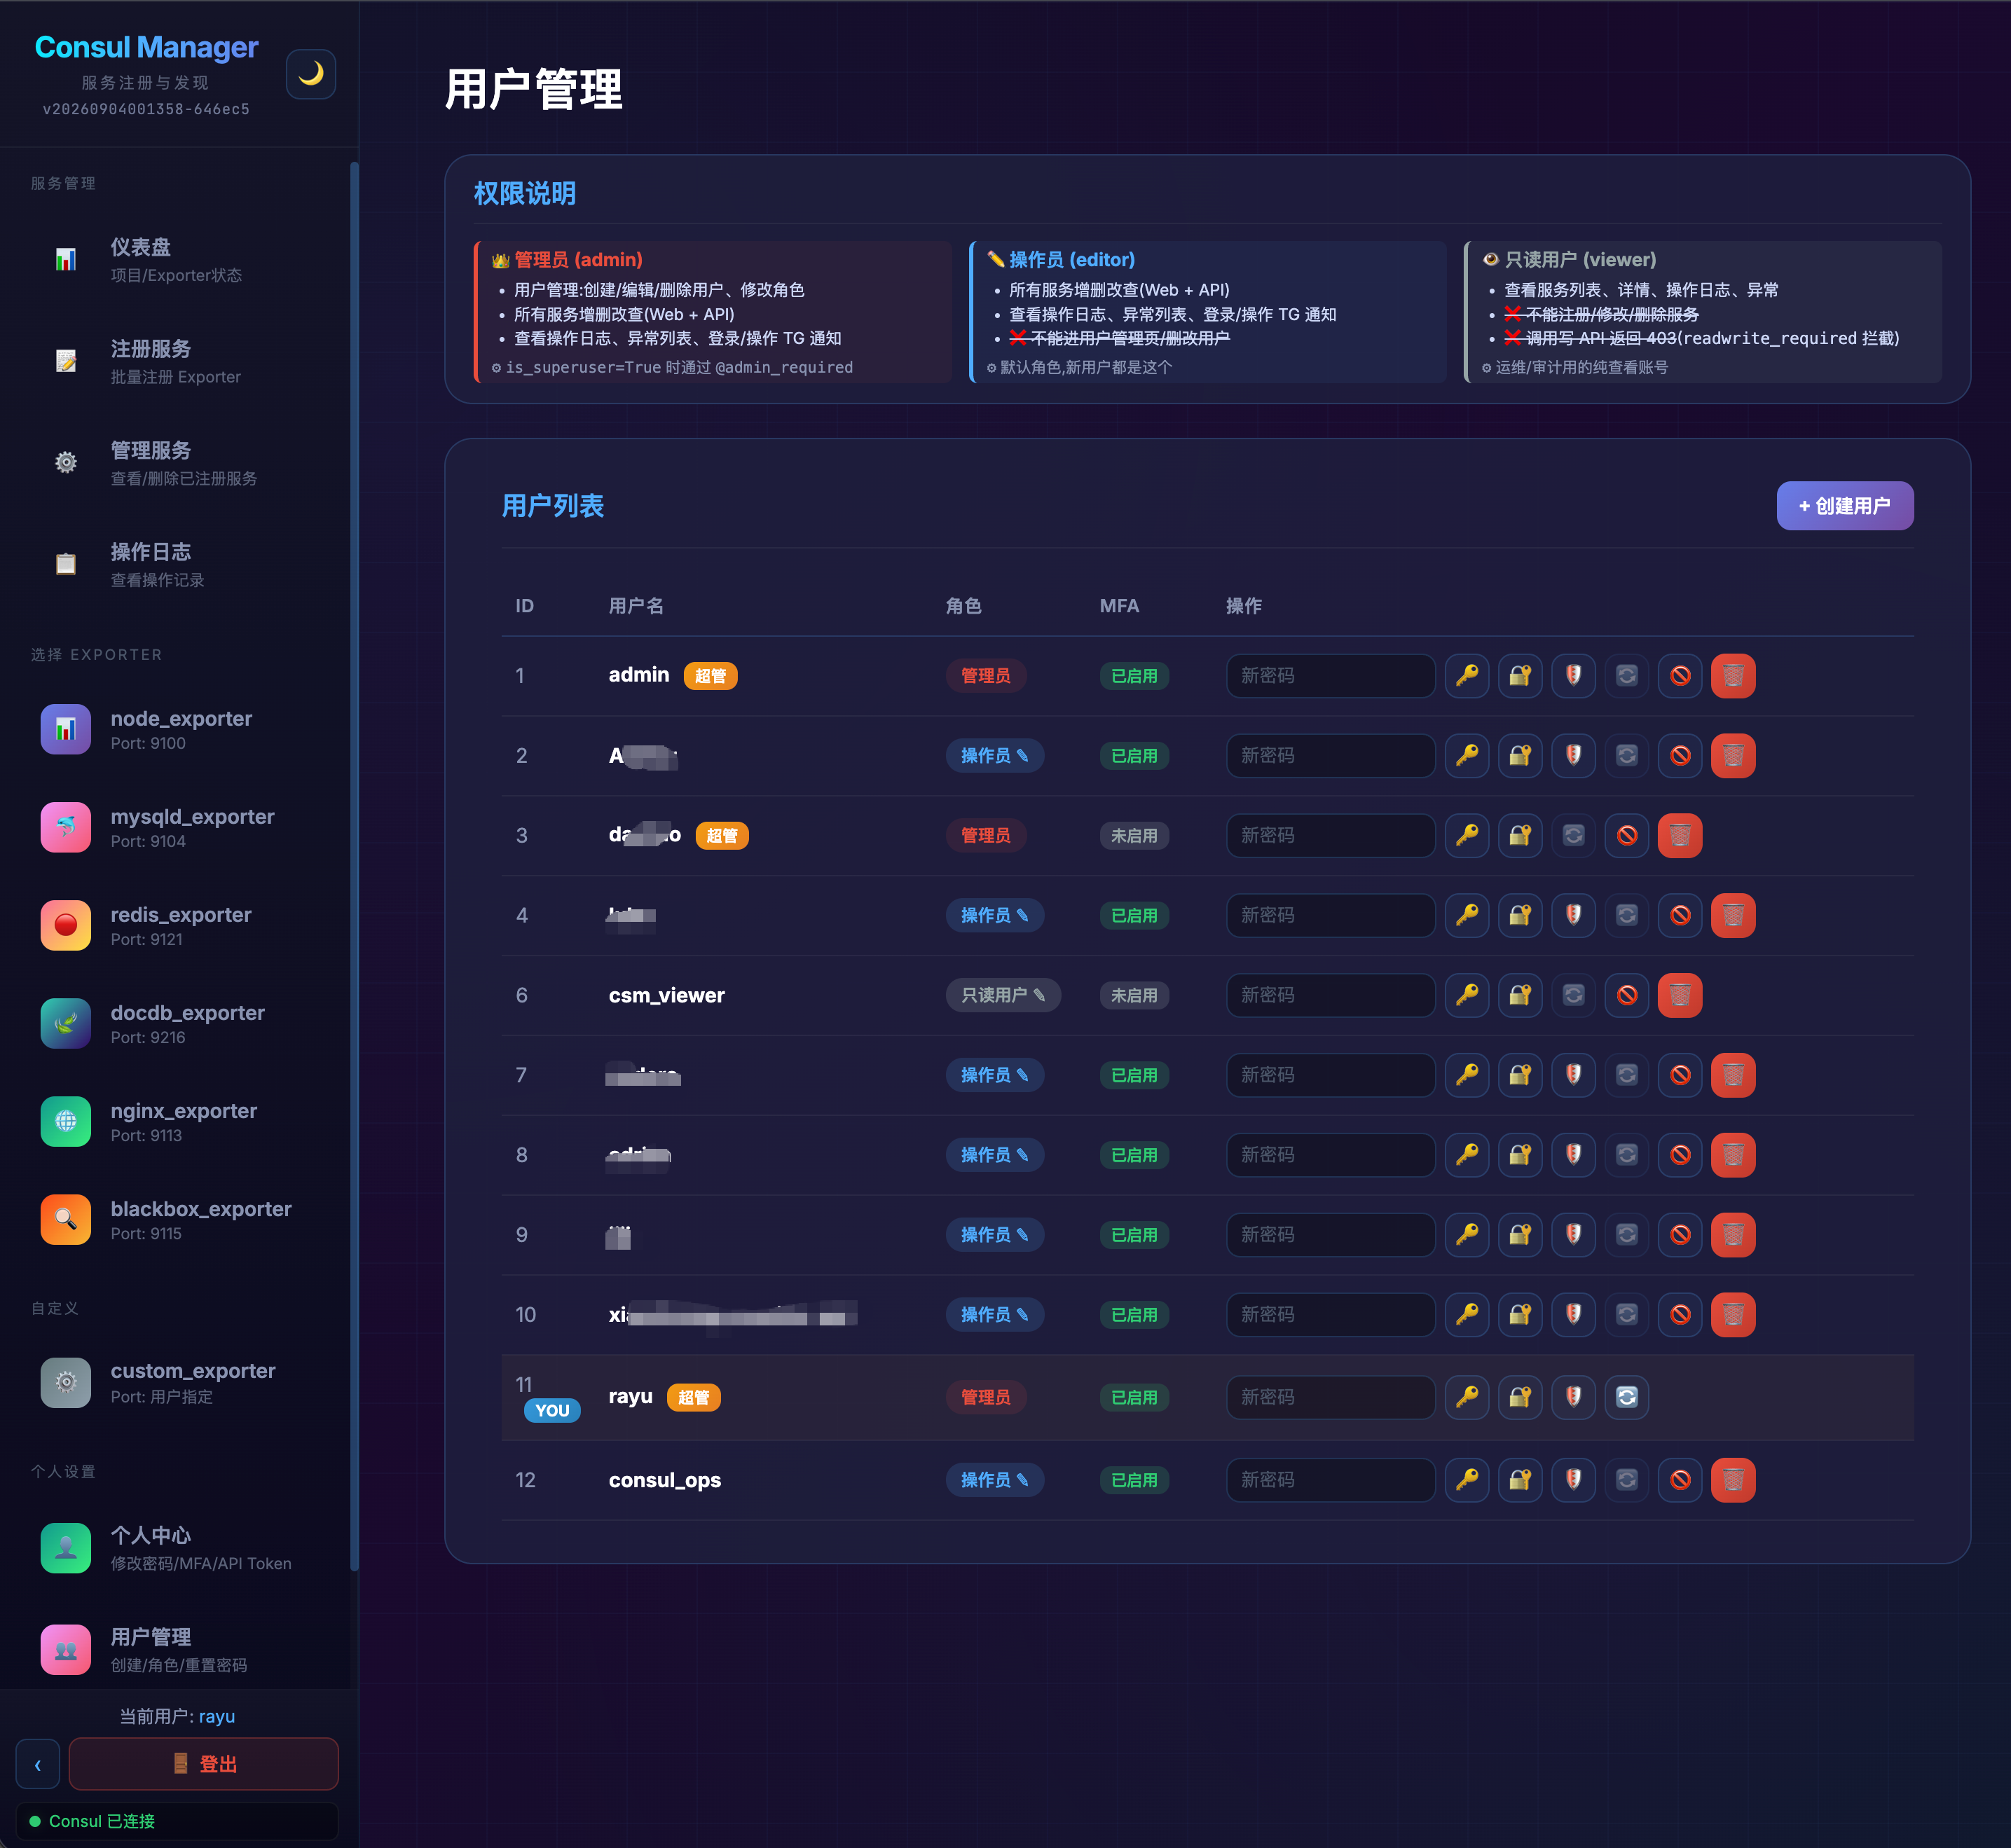
- 账号列表 + 角色(admin / operator / viewer)
- MFA 绑定状态、最后登录时间、所属团队
- 单用户 API Token 重置 / 吊销
MFA + Token + 只读账号
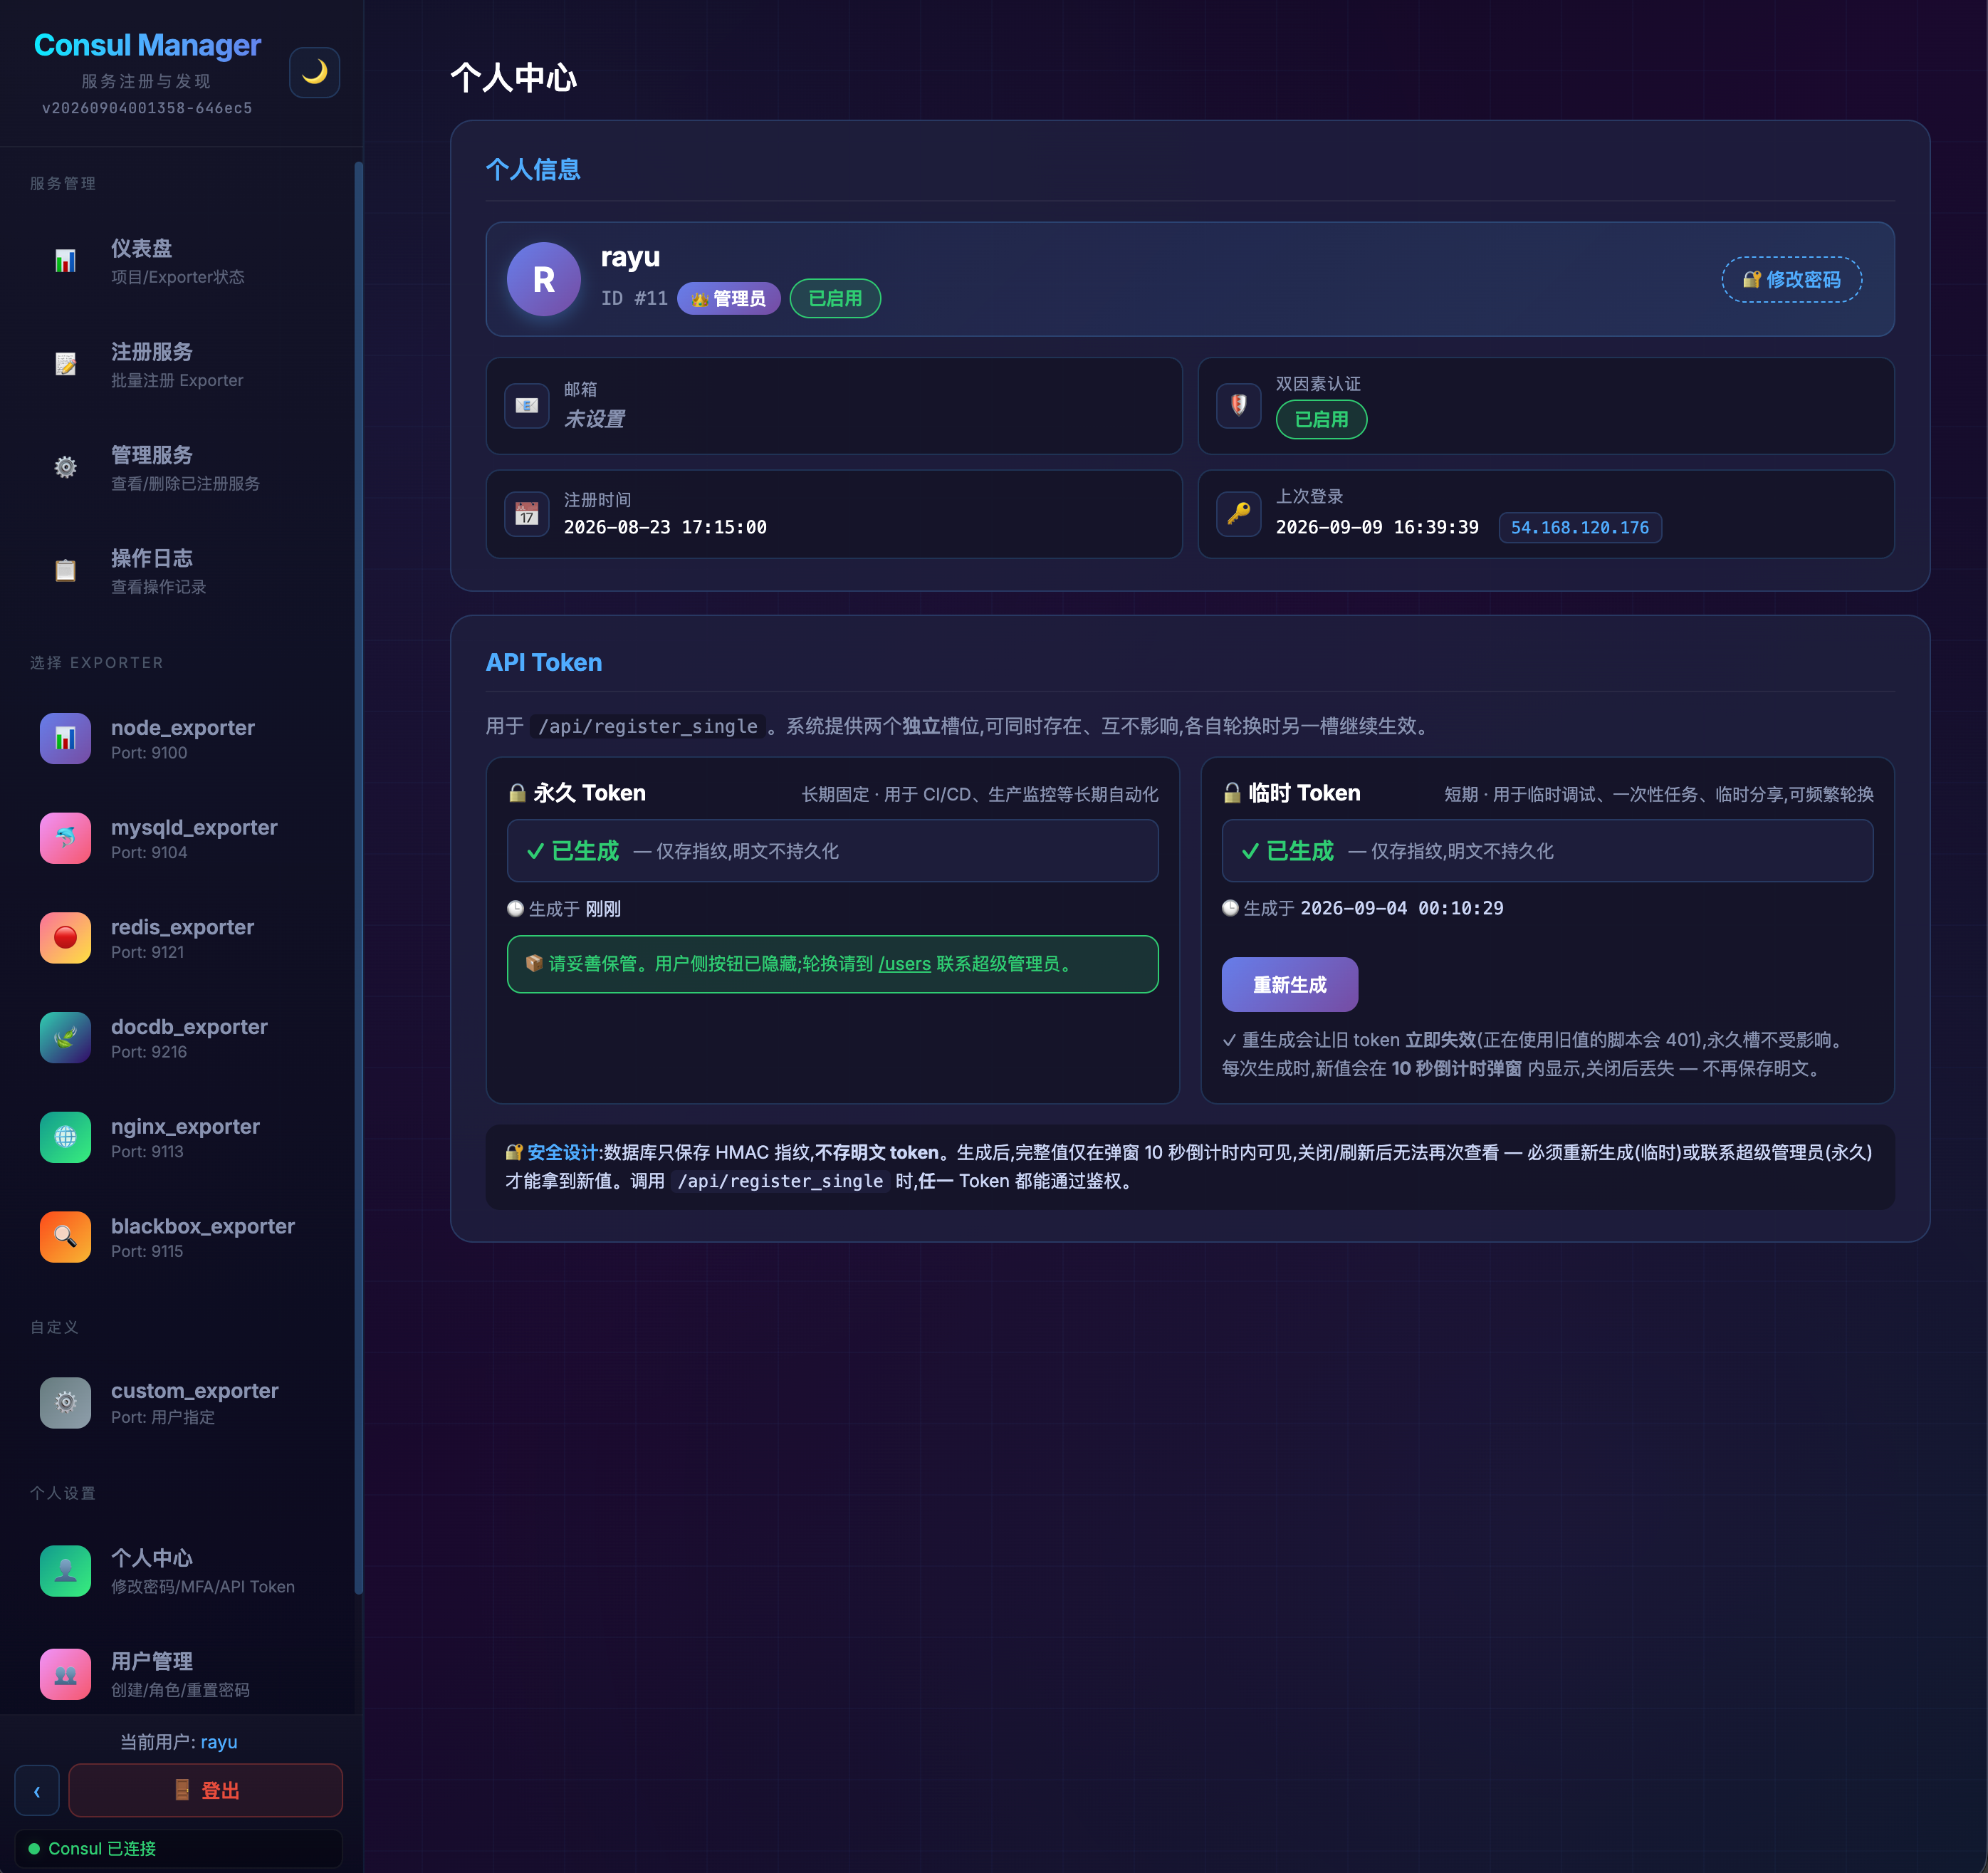
- 强制 MFA:所有非只读账号首次登录必须绑 Google Authenticator
- 个人 API Token:每位用户独立 Token,CI/CD 不需要共享全局密钥
- 只读账号:
role=viewer无需 MFA,可看不可改——为值班 / 审计 / 外部人员设计 - 会话超时:默认 1 周无操作过期
- 审计可追溯:所有写操作入日志,可追责到人
杀手级用法 · CI/CD 全流程无人值守
这是最常见的用法。当一个新游戏服 spg2-server-007 通过 Terraform / Ansible 起好之后,CI/CD 流水线会自动把它接入监控,全程无人参与。
全流程时序
1 | ┌──────────────┐ ┌──────────┐ ┌──────────────┐ ┌────────┐ ┌──────────────┐ |
整条链路 90 秒内完成,从 ECS 开通到 Prometheus 开始抓 /metrics,中间没有任何人工点。
Jenkinsfile 完整例子
在原本的 Provision / Configure 之后加一个 Register to Consul 阶段,机器自身的基本信息直接用 shell 取:
1 | pipeline { |
关键点:
$(hostname)/$(hostname -I)/$(hostname -i)直接从机器自身取,不需要 Terraform 输出解析- API 调用直接
curl,没有单独脚本 - 失败只发 Slack,不阻断流水线(机器已经起来了,注册失败可以人工补)
CI/CD 自动 vs 人工注册 · 6 个维度
| 维度 | 人工注册 | CI/CD 自动 |
|---|---|---|
| 耗时 | 5-10 分钟(含找 IP、填字段) | 1 次 curl,< 1 秒 |
| 错误率 | 高(IP 抄错、字段写错) | 0(变量从云 API 取) |
| 一致性 | 不同人填法不同 | 全公司一种格式 |
| 审计 | 「谁注册的?什么时候?」靠问 | 操作日志自动记录(操作人 = consul-ci,IP = CI 服务器) |
| 回滚 | 需要去管理页面删 | terraform destroy 触发 lifecycle hook 调 DELETE /api/service/<id> |
| 批量 | 一次 50 台要累死 | 流水线里加个 for 循环 |
同样适用于销毁流程
1 | # terraform-destroy 之后的清理 hook |
机器销毁 → 立即从 Consul 注销 → Prometheus 30 秒内停止抓取 → 监控数据自然清零。全生命周期自动化。
设计取舍
| 选择 | 理由 |
|---|---|
| 不存 Exporter 配置 | 配置归 Ansible / Terraform 管,本系统只做「注册」动作 |
| 不存监控数据 | 那是 Prometheus + Grafana 的事 |
| 24h 自动注销 | Exporter 异常关闭 24h 后自动从 Consul 消失,避免僵尸注册 |
| 强制 MFA | 写操作是生产变更,多一层认证防误操作 / 账号被盗 |
| 只读账号 | 内部工具经常要给外部 / 非运维人员开账号,只读角色是安全/便利的折中 |
| API Token + 全局 Token | 全局 Token 给平台用,个人 Token 给 CI 用,分权管理 |
技术栈
- 后端:Django 4.2 + Django REST Framework + MySQL 8.0
- 前端:原生 HTML/CSS/JS(无框架,模板渲染)
- 服务发现:Consul 1.x
- 认证:Django Auth + TOTP(Google Authenticator)
- 容器化:Docker + Docker Compose
为什么不用前后端分离?因为这是一个内部工具,UI 改动小,前端复杂度低,重度服务端渲染反而更稳。JS 只用来做交互增强(异步提交、健康检查刷新、toast 提示)。
不是什么
明确边界,避免过度设计:
- ❌ 不是 Prometheus:不存指标、不告警
- ❌ 不是 Grafana:不画图
- ❌ 不是配置中心:不存 Exporter 的配置文件(那是 Ansible / Terraform 的事)
- ❌ 不是 APM:不追踪请求链路
- ❌ 不是 K8s Operator:不能声明式管理
它只做一件事:把 Exporter 注册到 Consul,让 Prometheus 找得到。
总结成一句话
新服上线不再需要「运维手工加监控」——CI/CD 起完机器那一刻,Prometheus 就已经在抓数据了;机器销毁那一刻,监控就自动停了。中间没有任何人会忘记加监控、也没有人会加错。
适用规模
按当前架构合理支撑:
- 项目数:100+
- Exporter 实例:1000+
- 操作员人数:50+
- 只读账号:200+
- 注册峰值:单次批量 200 行
更大规模要考虑:拆分服务、分库、读写分离。当前版本未做。
🔒 暂不开源
 wechat
 alipay